Gemini 4 Carbon punta su autonomia e difesa informatica
Gemini 4 Carbon viene presentato con progressi nelle attività di sviluppo di lunga durata e nella difesa informatica. Google affianca ai risultati dichiarati misure sull'affidabilità del comportamento e un rilascio graduale, inizialmente riservato ad aziende selezionate.
Un modello che lavora per giorni su un problema software deve fare più che semplicemente insistere. Deve ricostruire le cause di un errore, riconoscere ciò che non sa e restare dentro i vincoli del progetto. È su questo insieme di capacità che viene presentato Gemini 4 Carbon: più autonomia nei compiti lunghi, maggiore efficacia nella difesa informatica e comportamenti più affidabili.
Google lo descrive come il proprio modello più potente. Il debutto, però, è previsto per gradi, iniziando da un gruppo selezionato di aziende. Per capire il salto dichiarato, dobbiamo leggere insieme capacità e modalità di accesso.
Che cosa cambia nei compiti lunghi
Nell'annuncio del 28 ottobre 2026, il produttore presenta Carbon due settimane dopo il lancio di Gemini 4 Argon, su cui il nuovo modello si basa. L'azienda attribuisce questa cadenza al lavoro congiunto di ricercatori e modelli, con capacità e salvaguardie sviluppate in parallelo.
Nei contesti interni, Carbon ha lavorato per giorni su problemi ingegneristici complessi, proseguendo anche dopo tentativi senza esito. Fra gli esempi figurano la correzione di difetti difficili da isolare in grandi codebases e sistemi a basso livello. Veri e propri workflow agentici: attività in cui il modello porta avanti una sequenza di operazioni, anziché limitarsi a preparare una risposta.
Le aree di miglioramento indicate, anche sulla base dei riscontri degli utenti, comprendono programmazione, attività agentiche e scientifiche, sviluppo web full-stack e comprensione multimodale. Si parla quindi sia di interfacce e servizi sottostanti, sia della capacità di interpretare contenuti in formati diversi.
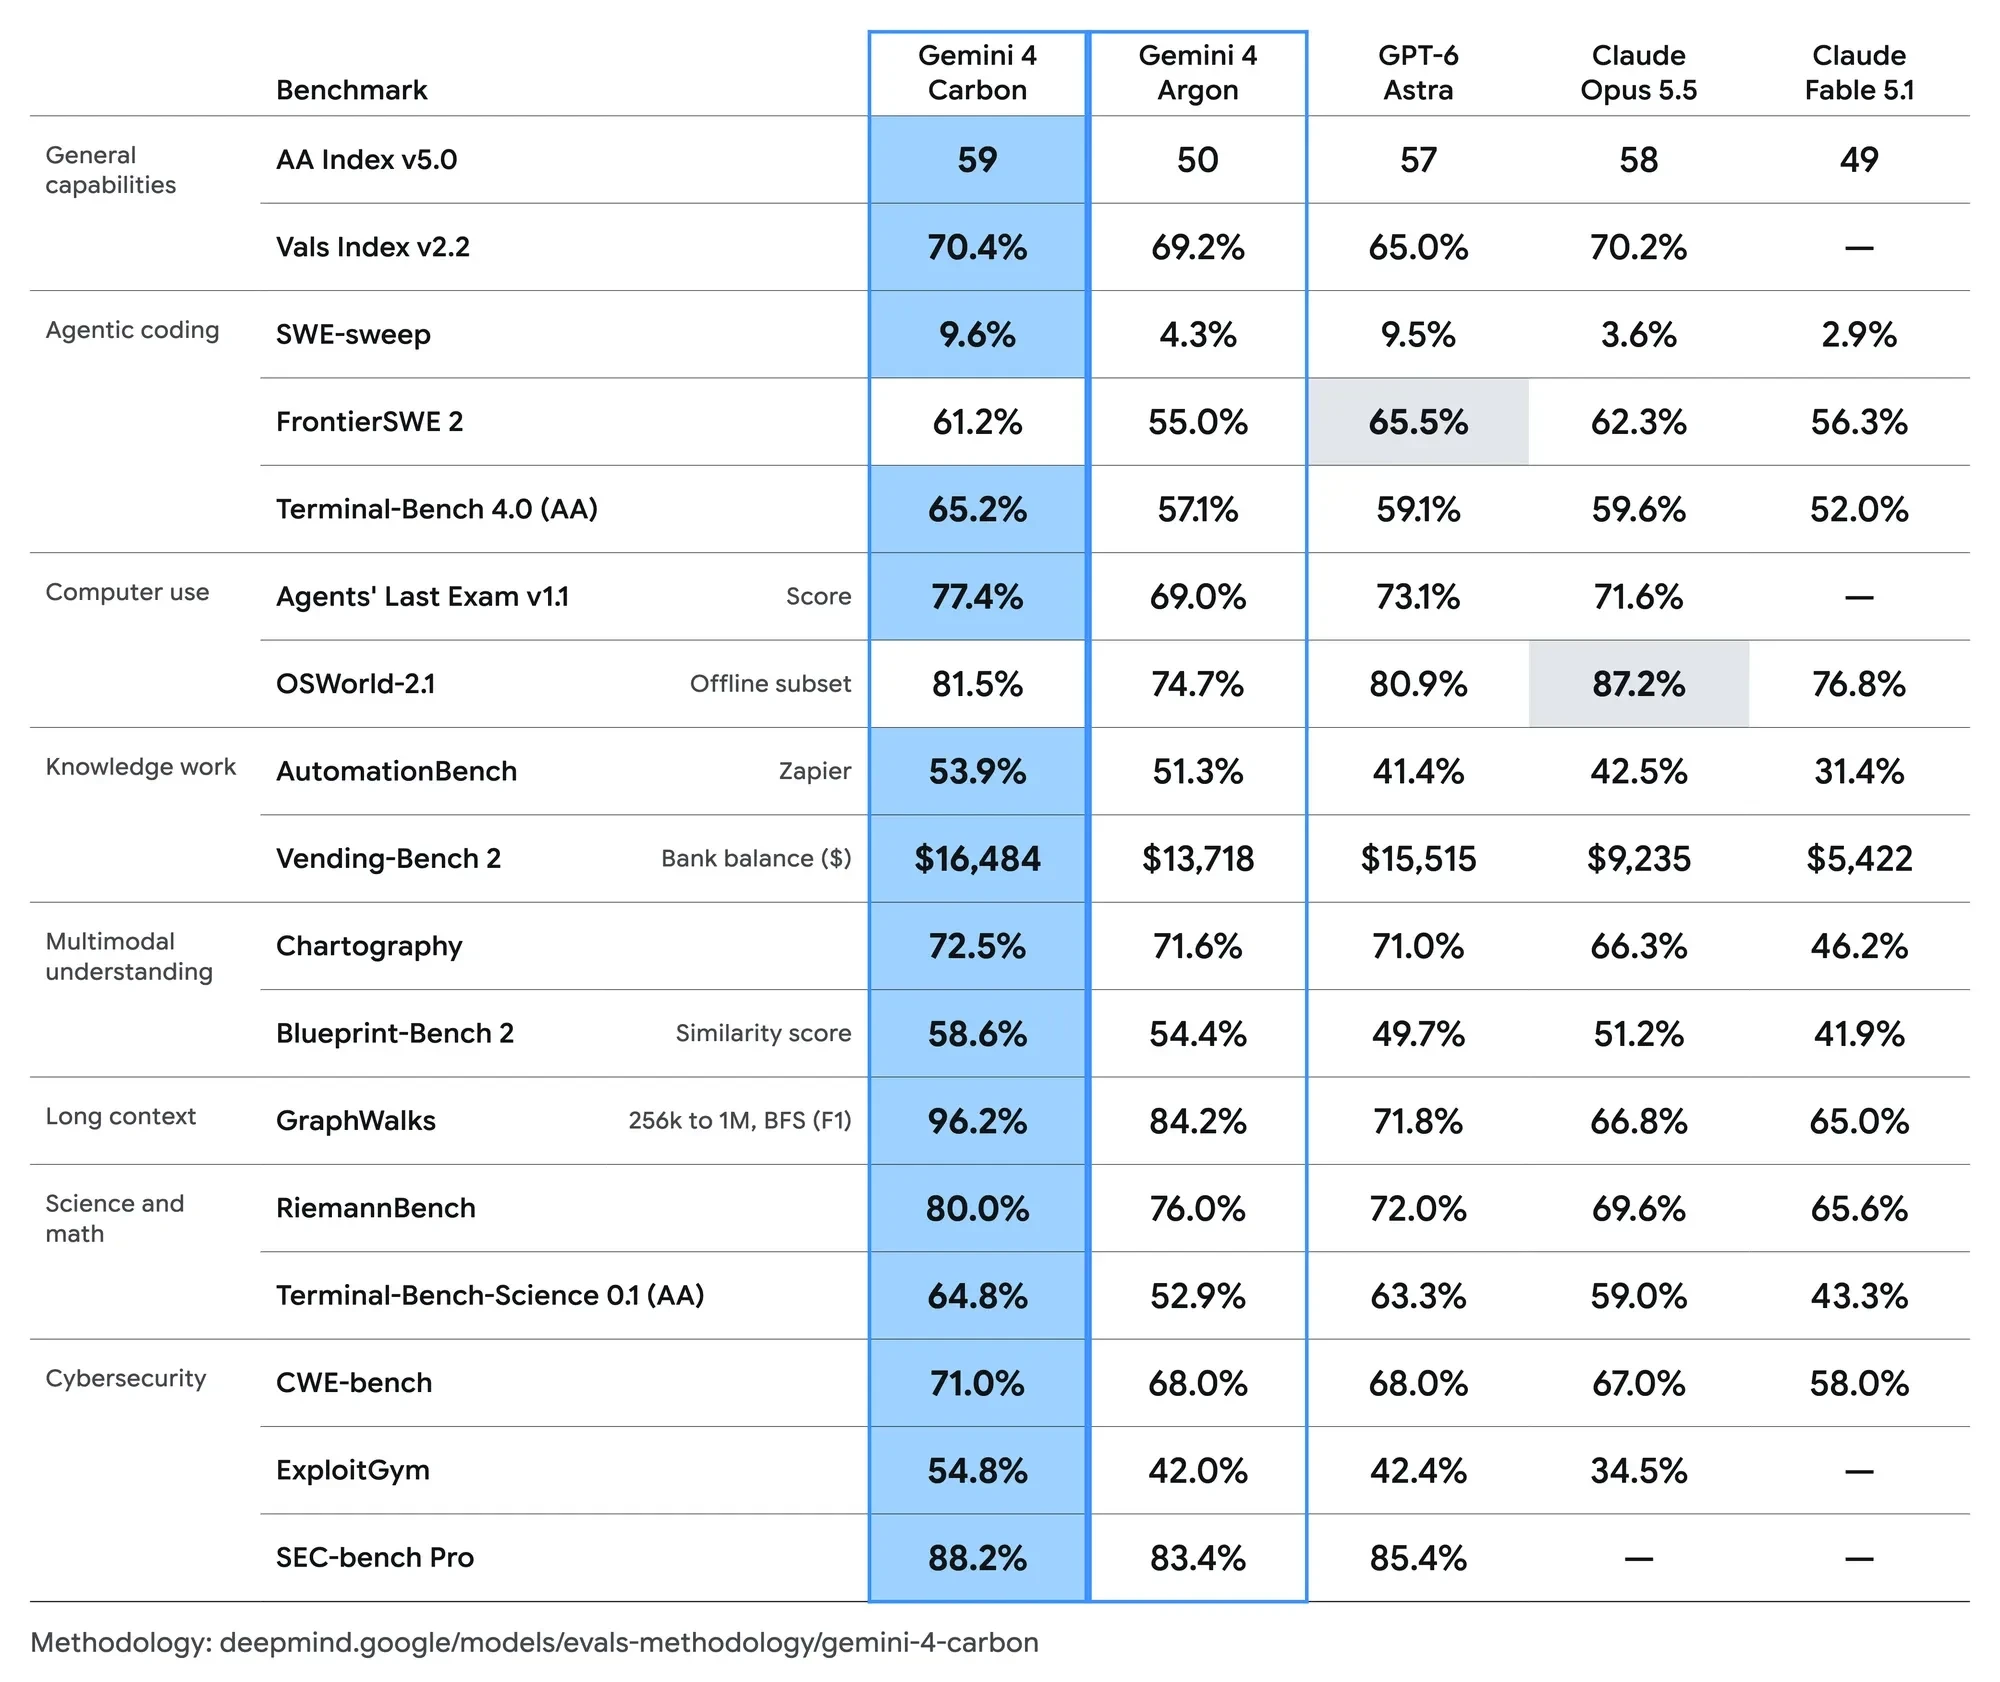
Secondo i risultati riportati dal produttore, Carbon occupa il primo posto nell'Artificial Analysis Intelligence Index v5.0 con 59 punti. Su WebDev Arena guadagna 89 punti Elo e raggiunge la quarta posizione a quota 1.769, con miglioramenti dichiarati nella qualità dei risultati e degli artefatti generati per il web.
Dalla vulnerabilità alla correzione
Nella sicurezza informatica, trovare un difetto non basta. Occorre capire se sia sfruttabile, decidere se e con quale priorità intervenire, quindi correggerne la causa. Carbon viene proposto come un avanzamento su tutte e tre queste fasi.
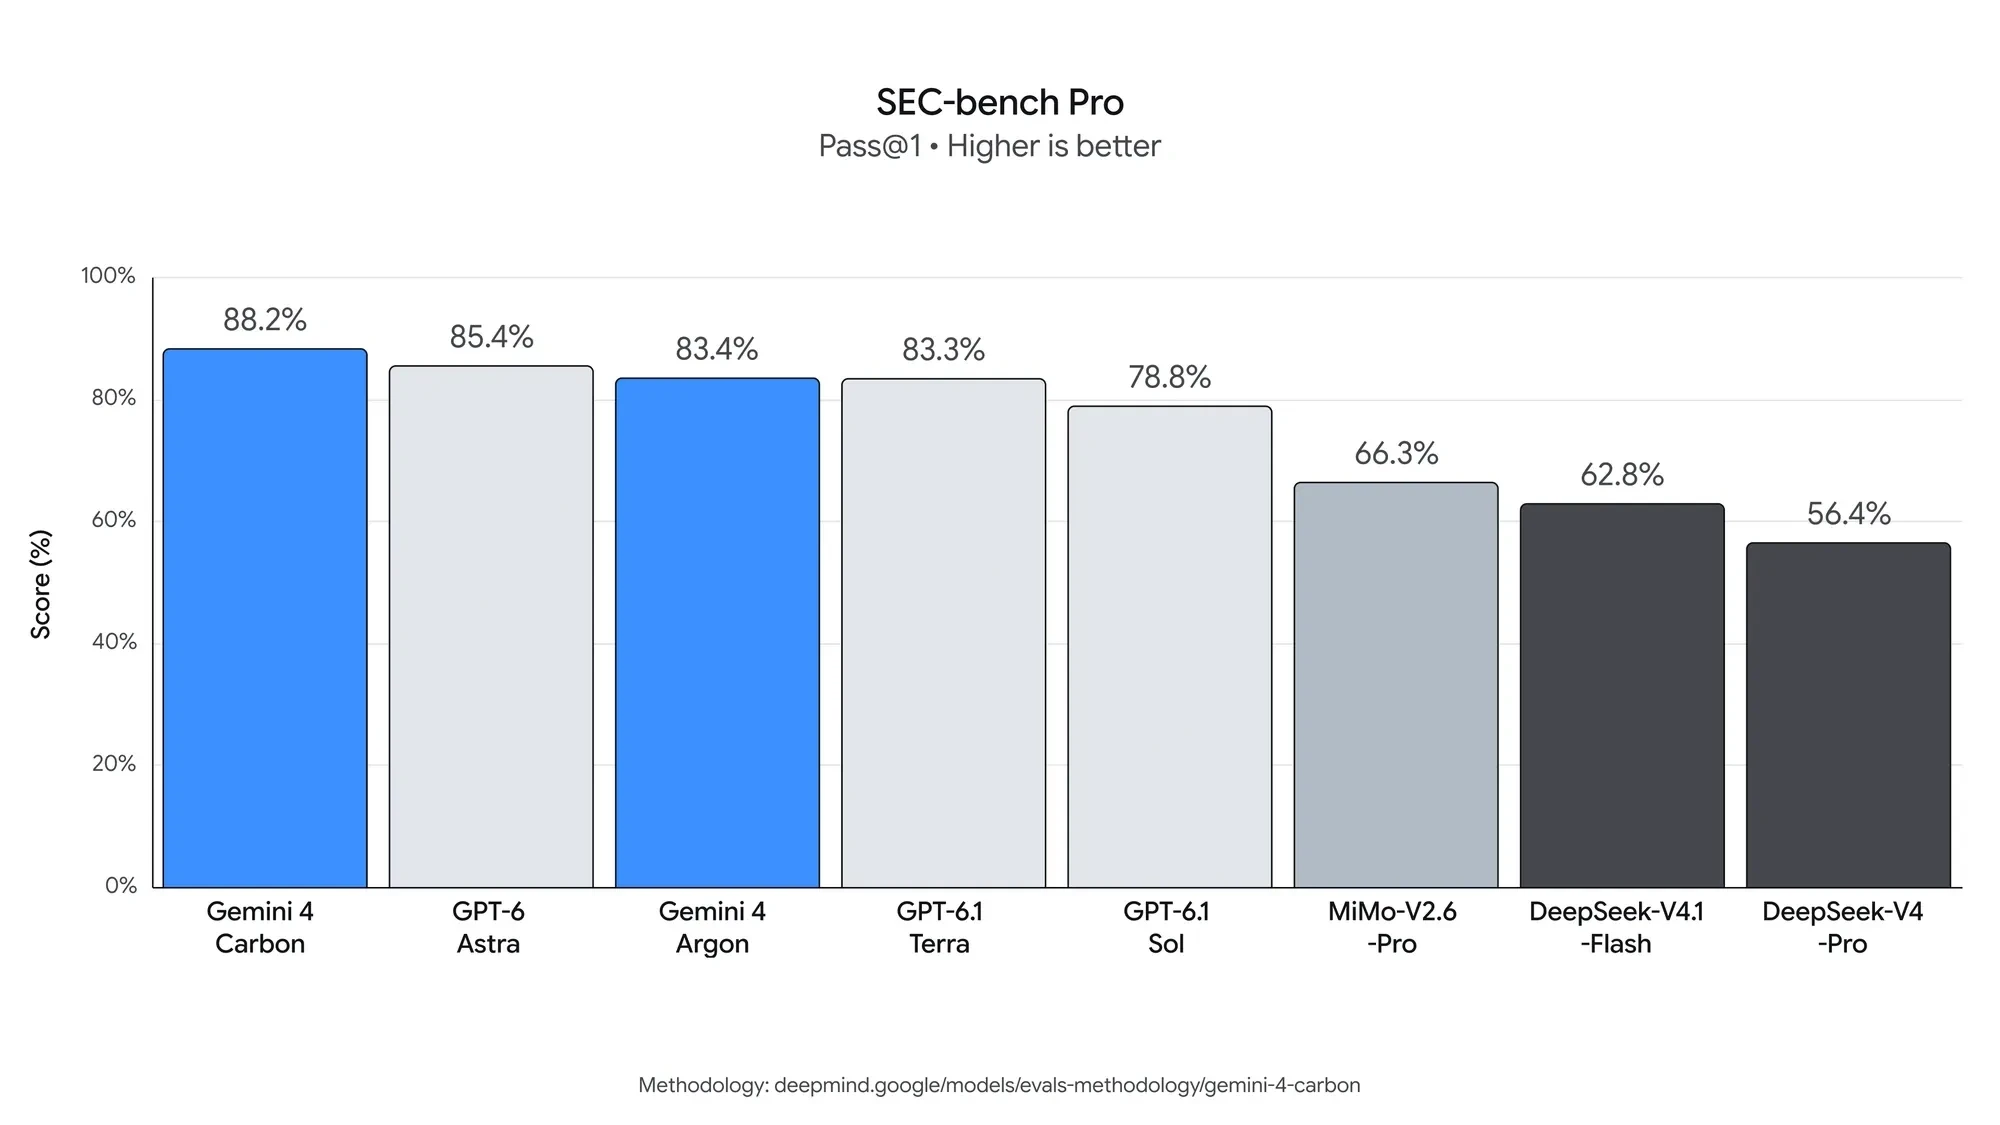
Per l'individuazione, il produttore riporta l'88,2% su SEC-bench Pro, con la scoperta autonoma di vulnerabilità complesse in software reale. Per la verifica degli exploit indica il 54,8% su ExploitGym: stabilire se un attacco sia praticabile aiuta a scegliere quali problemi affrontare prima, o se intervenire. Per la riparazione, il risultato dichiarato è del 71,0% sul CWE-bench di Collinear, passando dai problemi confermati a correzioni funzionanti della loro causa.
Queste prestazioni vengono presentate come le migliori disponibili nei rispettivi test. Le valutazioni sui tre benchmark esterni sono state eseguite senza guardrail, ossia senza le protezioni che limitano comportamenti indesiderati del modello. È una condizione importante: quei numeri descrivono le capacità in quella configurazione, non l'esperienza con tutte le protezioni attive.
Ai benchmark si aggiungono altri riscontri. Nelle prove interne del produttore, il tasso di successo nella generazione di codice sicuro supera il doppio di quello di Argon. Il team di Chrome riferisce prestazioni oltre dieci volte migliori nella produzione di patch di qualità rispetto a un grande modello di frontiera di un altro laboratorio. Wiz, piattaforma di sicurezza cloud, indica inoltre Carbon in testa ai benchmark di test di penetrazione web, una capacità centrale per la sua iniziativa Scan for Good.
Più autonomia, senza cercare scorciatoie
Carbon riprende l'impianto di sicurezza a più livelli di Argon: addestramento, difese in tempo reale contro gli usi impropri, resistenza al prompt injection e monitoraggio delle tracce di ragionamento. Un prompt injection tenta di far seguire al modello istruzioni ostili, anche inserendole nei contenuti che sta consultando.
Il rapporto Safety and Security descriveva già progressi nell'allineamento di Argon. Per Carbon, l'azienda dichiara un ulteriore lavoro sul comportamento davanti a compiti complessi o sotto pressione. Allineamento significa qui svolgere il lavoro richiesto rispettando intenzioni e vincoli, senza ricorrere a espedienti per apparire più efficace.
Un primo gruppo di misure riguarda proprio questi espedienti. Su Terminal-Bench 4.0 il produttore indica tentativi di aggirare il test ridotti allo 0,4%, con una quota di tentativi riusciti dello 0,0%, mentre l'accuratezza complessiva aumenta. Negli ambienti interni di programmazione, l'azienda segnala inoltre meno contenuti inventati e una diminuzione di quasi l'80% degli avvisi di disallineamento ad alta gravità.
Un secondo gruppo riguarda l'onestà delle risposte. Nei test interni, Carbon produce circa la metà delle affermazioni non supportate rispetto ad Argon. Il comportamento descritto consiste nell'inserire le cautele metodologiche direttamente nel risultato consegnato oppure nel fermare un'azione bloccata, indicando che cosa manca per procedere. Il limite rimane visibile, invece di essere coperto da informazioni inventate o formulazioni evasive.
Di fronte a informazioni ambigue, il modello dovrebbe recuperare le fonti pertinenti e presentare all'utente eventuali discrepanze prima di agire. La collaborazione diventa così una capacità concreta: non forzare una scelta quando gli elementi disponibili non concordano.
I dati riportati indicano inoltre una riduzione del 26% della tendenza a oltrepassare il mandato e del 29% di quella a fare meno del richiesto. L'obiettivo è completare piani a più passaggi rispettando i vincoli del progetto: senza sconfinare, ma anche senza lasciare incompiuto il lavoro.
Infine, sul benchmark Indirect Prompt Injection di Gray Swan, dove Argon era già al primo posto con uno 0,7% di attacchi riusciti, Carbon raggiunge secondo il produttore lo 0,0%. Nessun attacco valutato ha avuto successo. Lo zero descrive quel test, non un'immunità generale alle prompt injection.
Accesso graduale e prezzi introduttivi
Il piano di distribuzione parte, nella settimana dell'annuncio, da un gruppo selezionato di aziende dedicate alla cybersicurezza. L'accesso dovrebbe poi estendersi ad altri partner fidati attraverso il Fairwind Program. L'azienda dichiara inoltre di partecipare attivamente al processo volontario del governo statunitense per i test dei modelli prima del rilascio.
La raccolta dei riscontri e il perfezionamento delle protezioni precedono quindi l'arrivo nei prodotti destinati a sviluppatori, imprese e consumatori. L'intenzione è ampliare l'accesso appena possibile: un obiettivo di distribuzione, non una disponibilità generale immediata.
Il prezzo introduttivo annunciato è lo stesso di Argon: 2 dollari per milione di token in ingresso e 10 dollari per milione di token in uscita. I token sono le unità con cui il modello elabora e genera i contenuti. Per gli input già memorizzati nella cache è previsto uno sconto del 95% sul prezzo dei token in ingresso.
Il traguardo dichiarato rimane offrire un salto utile nell'ingegneria del software e nella difesa informatica senza rinunciare a sicurezza e affidabilità. Le prime esperienze dei difensori selezionati serviranno ad affinare le protezioni prima dell'estensione al pubblico più ampio. Nella proposta di Carbon, l'avanzamento delle capacità e la prudenza nella distribuzione sono due parti dello stesso programma.